深浅色
日常巡检与故障处理
这一篇是干什么的:平时怎么给系统"量体温",以及常见毛病怎么自己处理。
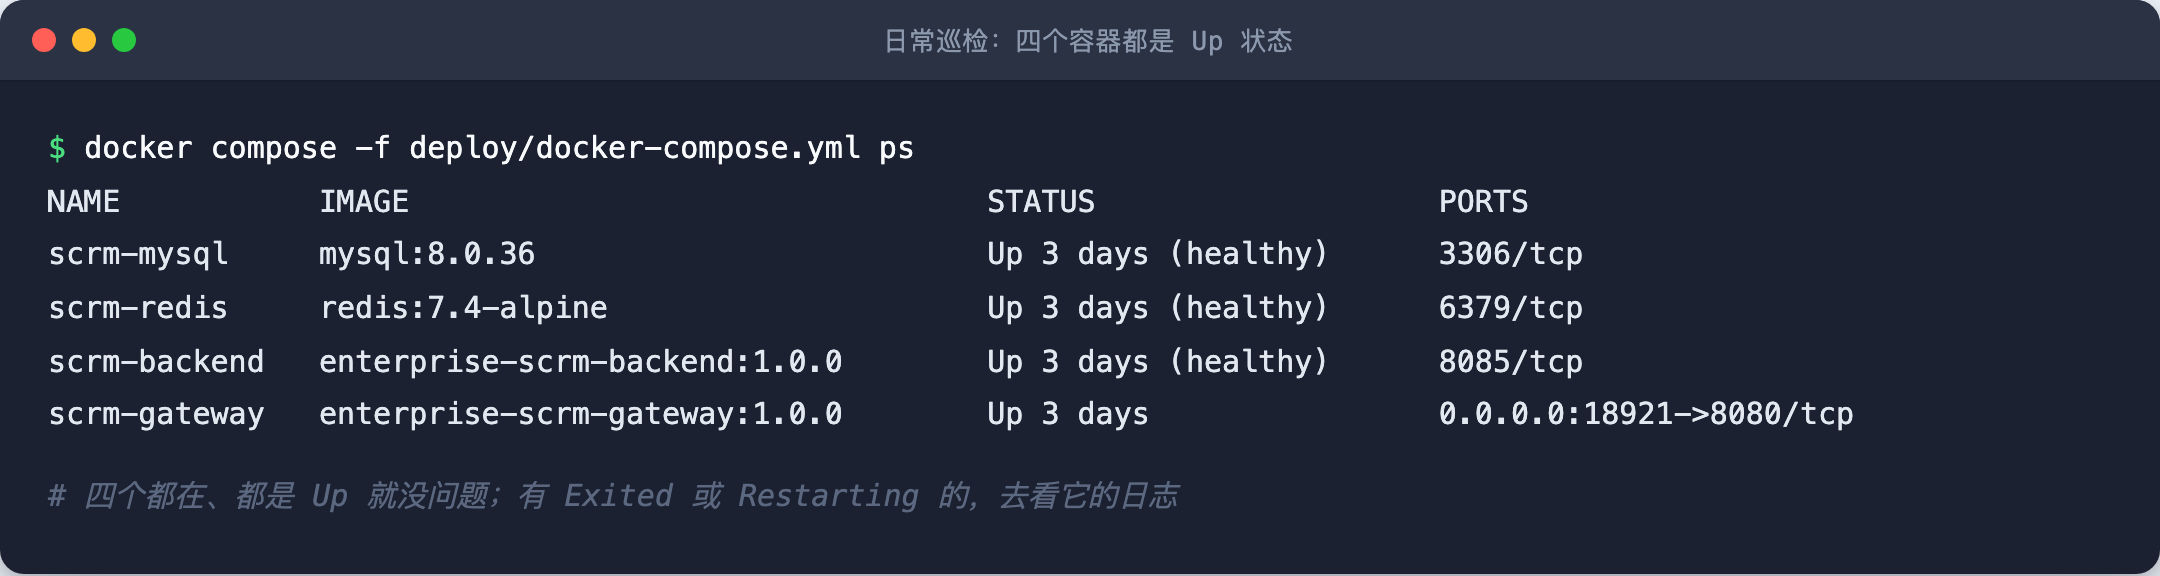
日常巡检(建议每天看一眼)
连上服务器,进入系统目录,依次跑这四条:
bash
docker compose --env-file .env -f deploy/docker-compose.yml ps
curl -fsS http://127.0.0.1:18921/healthz
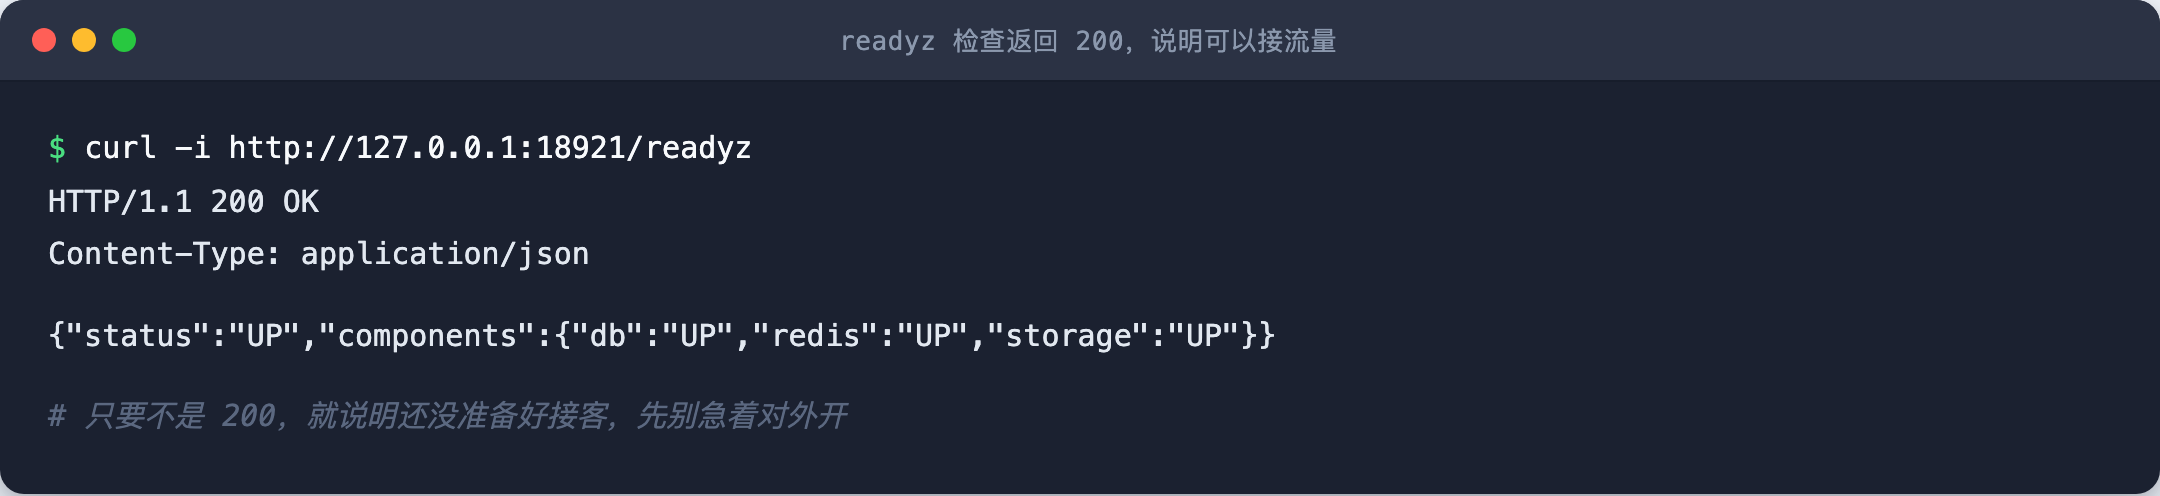
curl -i http://127.0.0.1:18921/readyz
docker compose --env-file .env -f deploy/docker-compose.yml logs --tail=200 backend gateway| 命令 | 看什么 | 正常长什么样 |
|---|---|---|
ps | 四个容器在不在 | 每一行状态都是 Up |
healthz | 程序活着吗 | 打印 ok |
readyz | 能接活吗 | 返回 200 |
logs | 最近的运行记录 | 没有 ERROR 刷屏 |
两个"体检指标"的区别(重点)
/healthz只说明"程序还活着"——像看人有没有呼吸。/readyz会检查数据库和缓存是否就绪。返回 200,才表示"能接活"。- 排查问题时,以
/readyz为准。
巡检还要看这三样
| 看什么 | 怎么查 | 为什么 |
|---|---|---|
| 磁盘空间 | df -h | 数据卷会一天天变大,满了系统会停摆 |
| 备份 | 看 backups/ 里最近的备份日期 | 备份断了要尽早发现 |
| 证书有效期 | 浏览器点小锁查看 | 证书过期,全站打不开 |
配置体检
bash
./scripts/config-check.sh它会把配置逐项检查一遍:密钥文件权限、公开地址、路径前缀等。
打印 configuration check passed 就是全过;否则按提示改对应的配置项。
常见故障对照表
| 现象 | 可能的原因 | 怎么办 |
|---|---|---|
| 网页完全打不开 | Nginx 挂了 / 证书过期 / 安全组没放行 443 | 依次排查:nginx -t、看证书、看安全组 |
| 502 Bad Gateway | 系统容器没在运行 | 用 ps 看容器,起不来看 logs |
| 页面能开,登录不上 | 后端异常 | 看 backend 日志 |
| 登录后一片空白 | 路径前缀不一致 | 跑 config-check.sh 按提示改 |
| 企微收不到消息、回调失败 | 回调地址或可信 IP 变了 | 到企微后台核对这两项 |
| 会话页面是空的 | 会话存档没开通,或没接入 | 看企业微信接入 |
| 群发发不出去 | 接口权限没开,或员工没确认 | 确认权限;提醒员工在企业微信里点确认 |
| 磁盘满了 | 备份、日志堆积 | 清掉旧备份;日志有大小上限,会自动滚动 |
| 容器反复重启 | 多半是资源不够 | 看 logs 里的记录;考虑升级服务器配置 |
一个排查小技巧:请求编号
每一次访问,系统都会带一个 X-Request-ID(一串编号)。
日志里用这个编号,能把"一次访问"从头到尾串起来。找问题时把这个编号报给技术支持,定位会快很多。
另外,系统日志是脱敏的:密钥、密码、客户聊天正文都不会写进日志。
监控(可选)
系统里带了监控配置的示例和告警规则:deploy/observability/prometheus/。
要接自己的监控系统,可以参考它来配。告警发到哪个群、报警阈值多少,这些要按你们自己的情况设置。
出事了先做这三件事
- 先备份:
./scripts/backup.sh,把数据先保住 - 留证据:把日志复制出来(
logs命令的输出),别急着重启 - 再动手:改配置前想清楚;拿不准就找技术支持。任何情况下不要敲
docker compose down -v
常见问题
Q:容器崩了会自动恢复吗?
会。四个容器都配了"出错自动重启",服务器重启后也会自己起来。
Q:能不能直接改数据库里的数据?
不要。所有数据修改都走系统页面,直接改表可能让系统状态对不上。
Q:日志在哪看?
用上面 logs 命令看最方便。日志文件存在系统的日志卷里,有大小上限,不会无限膨胀。
Q:系统要不要定期重启?
一般不用。容器是"出错自动重启"的,正常运行不需要人工重启。
相关页面
- 密钥与安全边界 — 钥匙和数据的边界
- 备份与恢复 — 出事之后的兜底
- 域名与 HTTPS 配置 — 打不开网页时先查这里
- 企业微信接入 — 回调类问题的排查